- הפעלת תוכניות LLM באופן מקומי מבטיחה פרטיות נתונים מוחלטת ועצמאות מחיבור לאינטרנט.
- כלים כמו Ollama ו-LM Studio הפכו את הגישה לפשוטה יותר, וביטלו את הצורך בידע מתקדם בתכנות.
- אופטימיזציה באמצעות כימות ופורמט GGUF מאפשרת למודלים רבי עוצמה לפעול על חומרה ביתית סטנדרטית.
כיום, יותר ויותר אנשים מתרחקים מלתת אמון עיוור בענקיות ענן כמו ChatGPT או Claude ובוחרים בבינה מלאכותית מקומית . הרעיון פשוט: במקום לשלוח את השאלות שלכם לשרת מרוחק, העיבוד מתבצע ישירות בחומרה שלכם. זו לא רק שאלה של סקרנות טכנית, אלא מחויבות איתנה לריבונות דיגיטלית ושליטה מוחלטת על המידע שאתם מטפלים בו.
הדבר המפתיע ביותר הוא שכבר לא צריך להיות אשף מחשבים או לבלות לילות שלמים בהתמודדות עם תלויות של פייתון כדי להשיג זאת. הודות לכלים שמפשטים את התהליך ככל האפשר, כל מי שיש לו מחשב מודרני למדי יכול להפעיל את העוזר החכם שלו תוך דקות ספורות, לחסוך בדמי מנוי חודשיים ולמנוע שימוש בשיחות שלו לאימון מודלים של אנשים אחרים.

היתרונות האמיתיים של הפעלת בינה מלאכותית באופן מקומי
כשאנחנו מדברים על פרטיות, זו לא סתם מילת מפתח; זוהי הכרח קריטי לכל מי שעובד עם מסמכים סודיים , כגון רשומות רפואיות, חוזים משפטיים או רישומי מחקר. על ידי הפעלת המודל על הכונן הקשיח שלך, אתה יכול להיות בטוח שאף טקסט לא יוצא מהמחשב שלך, ובכך לבטל את הסיכון ש-API חיצוני יאסוף את הנתונים שלך. יתר על כן, העובדה שהוא עובד במצב לא מקוון היא מצילת חיים אם אתה עובד בזמן נסיעה או באזורים עם כיסוי אינטרנט גרוע.
בטווח הארוך, חיסכון בעלויות הוא יתרון משמעותי נוסף, שכן ניתן לשכוח מחשבונות חודשיים. עם זאת, חשוב להיות מציאותיים ולא להיסחף מההייפ: לדגם קטן ומקומי לא יהיה אותו "ניצוץ" או דיוק כירורגי כמו לדגמים העצומים הפועלים על מחשבי-על, אך לשימוש יומיומי ומשימות ספציפיות, הם בהחלט מספיקים ובעלי יכולות מפתיעות.
חומרה: מה צריך כדי למנוע מהמחשב שלכם להתפוצץ?
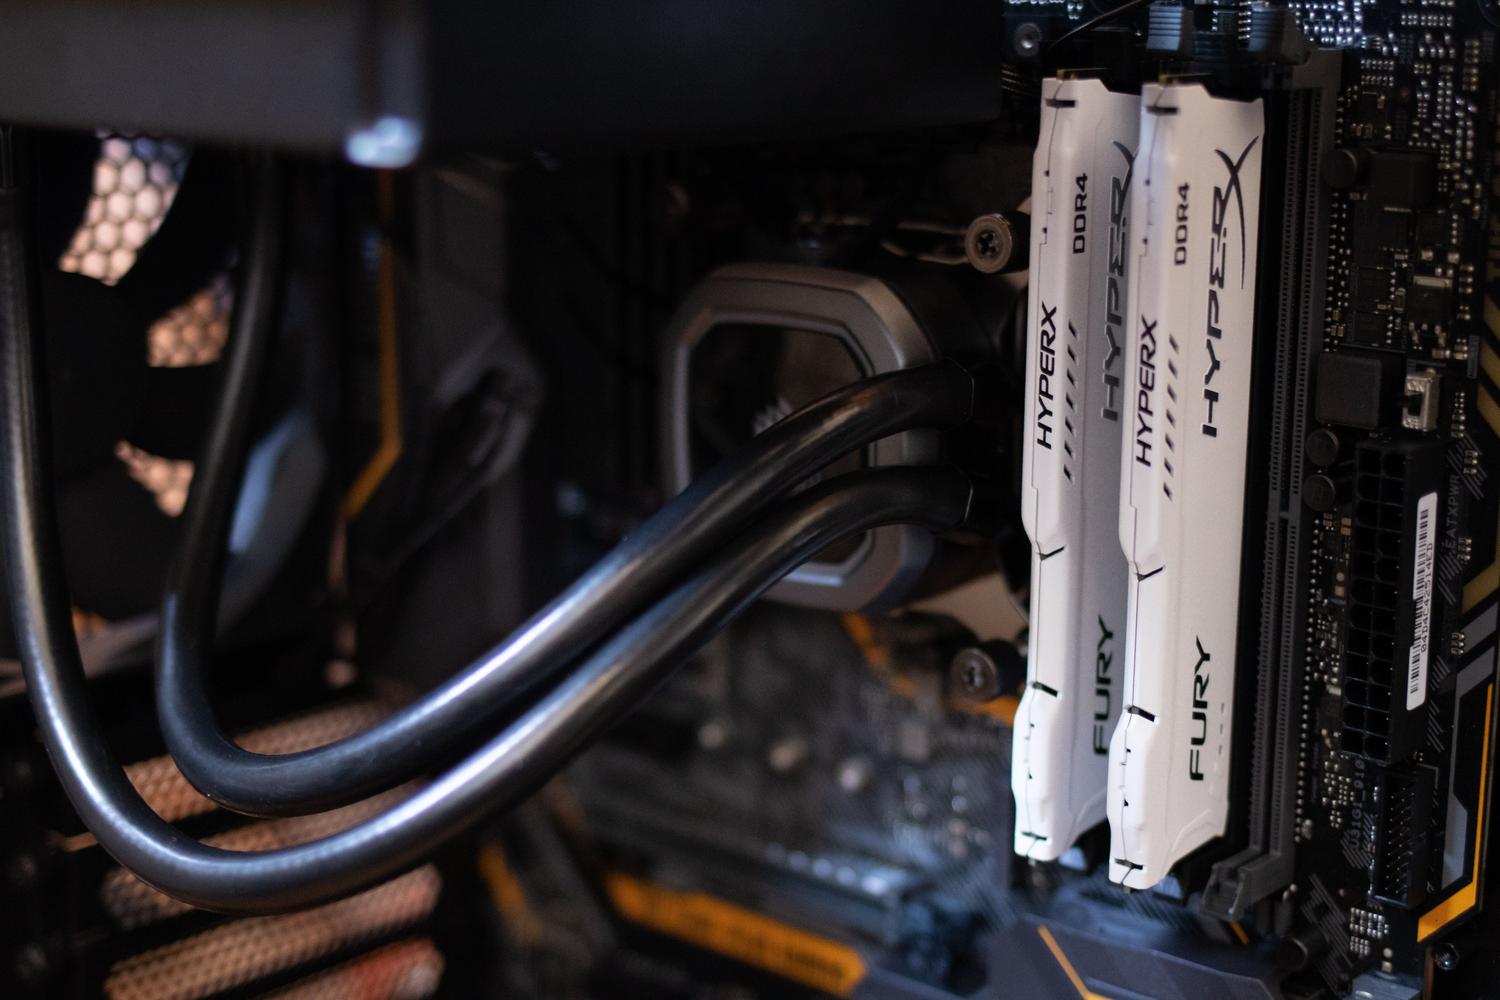
אל תיבהלו מכך שאתם צריכים את כרטיס המסך היקר ביותר בשוק כדי להתחיל לשחק. אם תבחרו בדגמים עם בין 3.000 ל-7.000 מיליארד פרמטרים, מעבד מודרני עם 16 ג'יגה-בייט של זיכרון RAM יפעל בצורה טובה למדי, אם כי עיבוד הטקסט יהיה איטי יותר. אם אתם רוצים לשדרג לדגמים חזקים יותר עם 13.000 מיליארד פרמטרים או יותר, כרטיס מסך עם לפחות 12 ג'יגה-בייט של זיכרון VRAM יעשה הבדל עצום במשחקיות חלקה.

כאן נכנסת לתמונה הקוונטיזציה , שהיא למעשה טריק טכני להפחתת הדיוק המספרי של משקלי המודל (לדוגמה, מ-16 סיביות ל-4 סיביות). זה מאפשר למודל לתפוס פחות זיכרון באופן משמעותי ללא אובדן איכות מורגש בשימוש יומיומי. מבחינה זו, פורמט GGUF הפך לסטנדרט הזהב להפצת גרסאות אופטימליות אלו.
כלים עיקריים: Ollama ו-LM Studio
אם אתם מחפשים את הדרך המהירה ביותר, Ollama ביססה את מעמדה כנקודת הכניסה המועדפת. היא פועלת כמו מנוע שפועל ברקע, טוענת בינה מלאכותית לזיכרון רק בעת הצורך ומשחררת אותה לאחר מכן כדי למנוע האטה של המערכת. היא דומה מאוד לפילוסופיה של Docker, המתייחסת למודלים כחבילות עם גרסאות. יתר על כן, היא תואמת למשפחות קוד פתוח חזקות כמו Llama, Mistral, Gemma ו-Qwen.
למי ששונא את הטרמינל ומעדיף ללחוץ על כפתורים, LM Studio מציע ממשק גרפי אינטואיטיבי ביותר המאפשר לכם לנהל הורדות והגדרות מחלון אחד. ואם אתם רוצים שהבינה המלאכותית שלכם תנתח את הקבצים האישיים שלכם, תוכלו להתקין את Open WebUI (אשר מחקה את המראה והתחושה של ChatGPT) ולהוסיף מודל הטמעה כמו nomic-embed-text כדי לבצע חיפושים סמנטיים במאגר הידע המקומי שלכם.
איך להפעיל אותו ולשמור עליו פועל
התהליך הרגיל מתחיל בהורדת המתקין מאתר האינטרנט הרשמי של Ollama עבור Windows, macOS או Linux. לאחר ההתקנה, מומלץ לוודא שהשירות פעיל, מכיוון שהוא מאזין לפורט 11434 כברירת מחדל . משם, פשוט בוחרים מודל מהספרייה, מורידים אותו עם פקודה ומתחילים לשוחח בצ'אט. אם אתם מתכננים להגדיר שרת ביתי שתמיד פועל, מומלץ מאוד להגדיר את השירות כך שיופעל אוטומטית כדי למנוע בעיות לאחר הפסקת חשמל.
מגבלות ומציאות של המודל המקומי
יתר על כן, עדיין יש עקומת למידה קלה אם ברצונך להתאים פרמטרים כמו טמפרטורת יצירה או גודל הקשר. בעוד שממשקים נוכחיים ייעלו מאוד את התהליך בהשוואה לפני כמה שנים, הבנת האופן שבו הגדרות אלו משפיעות על התוצאות היא המפתח להשגת תגובות מדויקות או יצירתיות יותר, בהתאם לצרכים שלך.
השינוי שעברה טכנולוגיה זו הוא מדהים: מה שבעבר דרש קומפילציה של קוד והתמודדות עם פייתון נפתר כעת באמצעות מתקין פשוט. מעבר מתלות מוחלטת בענן לשליטה מוחלטת על הנתונים שלך הוא אלטרנטיבה בת קיימא לחלוטין לכל מי שמעריך את פרטיותו הדיגיטלית ורוצה להתנסות בבינה מלאכותית מבלי לשלם עבור מנויים או להתפשר על פרטיותו.
